SEO довго будувалося навколо зрозумілої послідовності: пошуковий робот обходить сторінку, індексує її, користувач бачить результат у SERP і переходить на сайт. У 2026 році між сайтом і людиною дедалі частіше з’являється ще один учасник — AI-система. Вона може знайти сторінку, витягнути з неї факти, порівняти пропозицію з конкурентами й сформувати відповідь ще до переходу користувача. Через це технічна основа ресурсу — швидка відповідь сервера, доступність сторінок для потрібних краулерів, стабільний рендеринг — знову набуває ваги. Для проєкту з помітним бот-трафіком гарний VPS може виявитися не менш практичним елементом SEO-інфраструктури, ніж кешування, CDN чи оптимізований CMS-стек.
Пошук вже не завжди закінчується кліком
Зміни добре видно на Google. AI Overviews здатні дати розгорнуту відповідь без необхідності відкривати кілька результатів пошуку. Паралельно AI-помічники працюють як окремий інтерфейс до вебу: користувач ставить питання природною мовою, а система сама шукає джерела, зіставляє їх і повертає синтезовану відповідь.
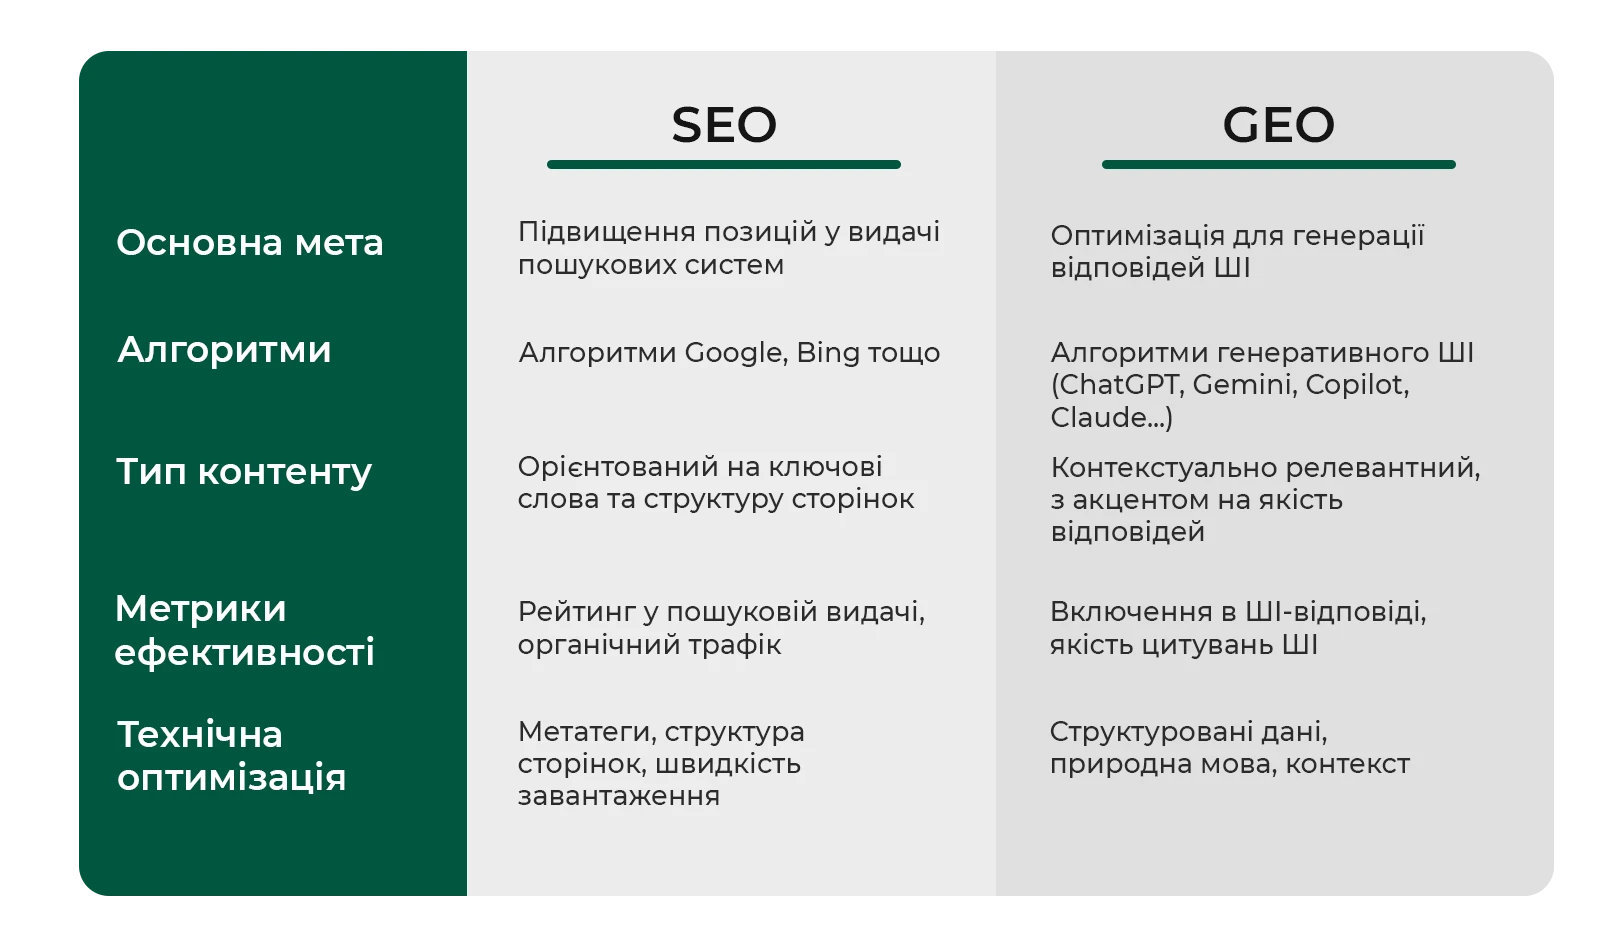
Для SEO це створює незручну, але важливу ситуацію. Сайт може залишатися джерелом інформації навіть тоді, коли сесія в аналітиці так і не з’явилася.
Pew Research Center проаналізував 68 879 пошукових запитів Google у дослідженні поведінки 900 дорослих американців. За наявності AI-зведення користувачі переходили на звичайні результати у 8% відвідувань SERP, без такого зведення — у 15%. На джерело безпосередньо з AI-зведення переходили лише в 1% випадків.
Вибірка стосується США і березня 2025 року, тому механічно переносити ці цифри на український пошук не варто. Але напрямок зміни очевидний: цитування сторінки AI-системою та отримання кліку стають різними подіями.
Звідси виникає нове питання для SEO-фахівця. Недостатньо з’ясувати, чи індексується URL у Google. Треба розуміти, чи може потрібний AI-краулер отримати контент і чи достатньо добре структурована сама сторінка, щоб машина правильно визначила її зміст.
Краулер, AI-пошук і агент — не одне й те саме
Під загальною назвою AI-боти сьогодні ховаються різні сценарії. Один робот може збирати дані для навчання моделей, другий — індексувати контент для пошукового продукту, третій приходить у момент, коли користувач доручив AI-агенту знайти товар, прочитати документацію або дослідити певну тему.
Ця різниця принципова. Власник сайту цілком може не хотіти віддавати весь контент для тренування моделей, але водночас бути зацікавленим у тому, щоб його сторінки знаходили системи, які здатні привести потенційного клієнта.
Cloudflare у своєму аналізі AI-crawling за 2025 рік розділяла активність саме за призначенням. За її даними, близько 80% AI-краулінгу за попередні 12 місяців припадало на навчання моделей, 18% — на пошук і приблизно 2% — на дії, ініційовані користувачами. Пізніше компанія повідомила, що протягом 2025 року активність категорії user action зросла більш ніж у 15 разів.
Це вагомий аргумент проти правила заблокувати всіх AI-ботів одним записом і забути. robots.txt та правила WAF варто переглядати за конкретними User-Agent і завданнями, а не за словом AI у назві.
Машині потрібна сторінка без загадок
Класичне SEO вже навчило нас працювати зі структурою документа: один зрозумілий предмет сторінки, логічна ієрархія заголовків, семантичний HTML, внутрішні посилання, canonical, sitemap, структуровані дані там, де вони доречні. Для AI-пошуку більшість цих практик не втратила сенсу.
Але контент доведеться оцінювати ще й з погляду вилучення фактів.
Уявімо сторінку VPS-провайдера. Людина здатна переглянути красиві картки тарифів і зрозуміти різницю між ними. Машині простіше, якщо сторінка однозначно повідомляє: який обсяг RAM входить у тариф, скільки vCPU доступно, де розташований дата-центр, яка операційна система підтримується, чи є резервне копіювання та скільки коштує послуга.
Те саме стосується інформаційної статті. Якщо автор на 8000 знаків розтягує відповідь, яку можна було сформулювати двома реченнями, текст не стає експертнішим. Сильніша модель — спочатку дати конкретну відповідь, а потім показати аргументацію, винятки, власний досвід, цифри та джерела.
Особливо корисні для машинного читання таблиці характеристик, послідовні H2/H3, короткі визначення складних понять, FAQ там, де питання справді виникають у користувачів, дати оновлення матеріалів та чіткі зв’язки між сутностями. Schema.org може допомогти описати тип і властивості контенту, але сама розмітка не перетворить слабку сторінку на авторитетне джерело.
Технічне SEO отримує нового клієнта
AI-краулер не оцінить дизайн очима, зате зіткнеться з тими самими HTTP-відповідями, редиректами, тайм-аутами та помилками сервера, що й будь-який інший клієнт.
Тому корисний аудит у 2026 році виходить за межі Lighthouse. Варто окремо перевірити access.log: які AI User-Agent реально приходять, скільки запитів роблять, які URL обходять, які коди відповіді отримують і чи не впираються в 403 або 429. Заодно можна побачити ботів, які називають себе відомими краулерами, але поводяться підозріло.
Друга зона ризику — JavaScript. Якщо основний текст, ціна або характеристики з’являються тільки після складного клієнтського рендерингу, не слід автоматично припускати, що кожен сторонній агент виконає JS так само, як браузер користувача. Для критичного контенту серверний HTML залишається найбільш передбачуваним варіантом.
Третя проблема — агресивний захист. Rate limiting потрібен, але правило на кшталт 10 запитів за хвилину для будь-якого невідомого бота може одночасно відсікати корисний краулер. Тут немає універсальної цифри: потрібно дивитися на потужність сервера, поведінку конкретних роботів і журнали запитів.
Не кожен AI-бот приносить аудиторію
Традиційна угода між сайтом і пошуковиком була досить зрозумілою: робот отримує доступ до контенту, а пошуковик натомість може привести користувача. У генеративному пошуку цей обмін став значно менш симетричним.
За даними Cloudflare, у липні 2025 року на один перехід від OpenAI припадало приблизно 1091 звернення її краулерів до HTML-сторінок, у Perplexity — близько 195. Для Anthropic співвідношення перевищувало 38 тисяч до одного.
Cloudflare окремо застерігає, що переходи з нативних застосунків не завжди передають Referer, тому такі співвідношення можуть завищувати розрив. Проте для вебмайстра сам масштаб різниці достатньо показовий.
Звідси випливає практичний підхід: доступ AI-ботів — це бізнес-рішення, а не новий чекбокс у технічному SEO. Для медіа, яке монетизує перегляди, безконтрольний краулінг може бути невигідним. Для B2B-компанії одна коректна згадка в AI-відповіді на вузький комерційний запит потенційно цінніша за десятки випадкових інформаційних сесій.
Як вимірювати AI-трафік
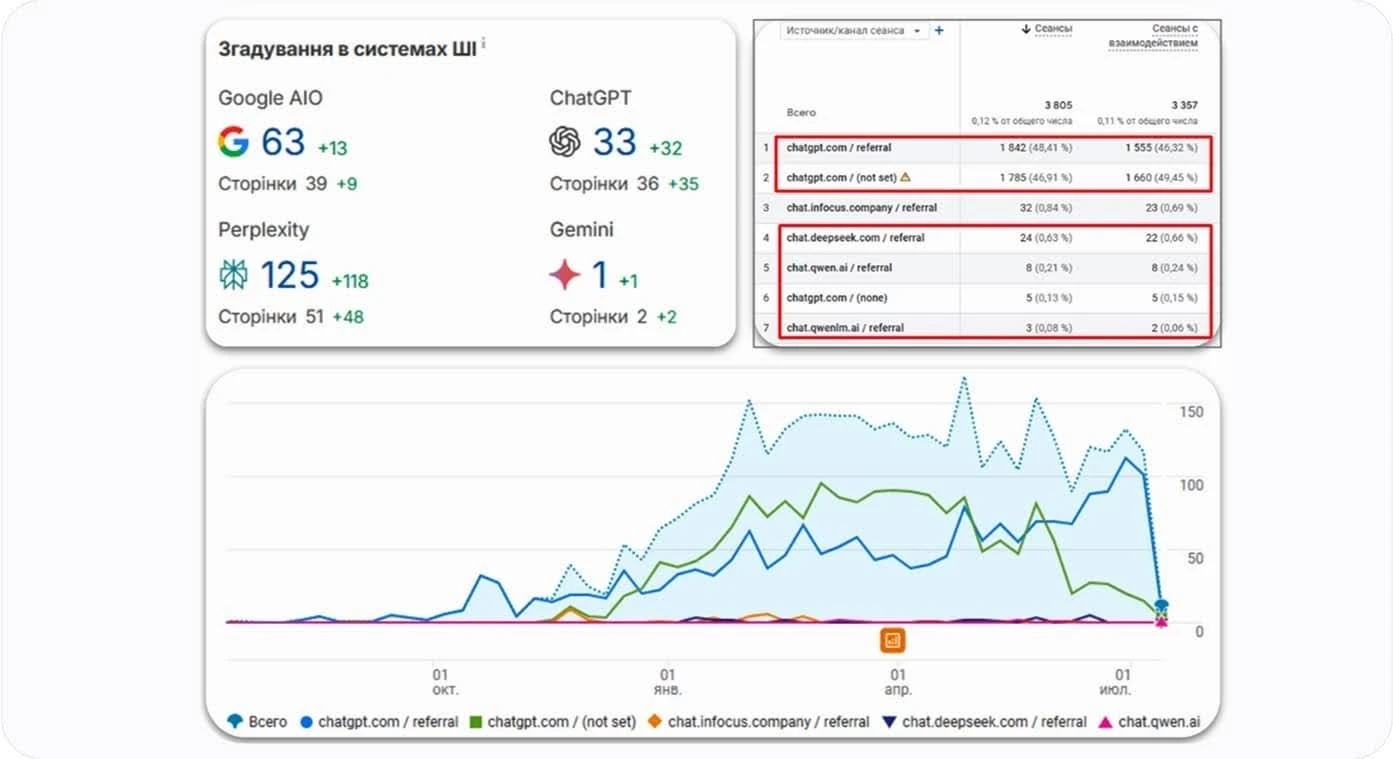
У GA4 реферальні переходи з AI-сервісів варто винести в окремий сегмент або channel group. Це дозволить бачити не лише sessions, а й engagement, заявки, покупки та assisted conversions. Частина переходів загубиться через застосунки й відсутність referrer, тому абсолютної точності тут не буде.
Серверні логи дають іншу половину картини. Вони показують не людей, а інтерес машин до сайту. Які розділи найчастіше обходять? Чи почав новий бот активно завантажувати сторінки? Яка частка відповідей 200, 301, 403, 404, 429 і 5xx? Чи є сплески навантаження?
Для інформаційних проєктів можна додати ще один рівень спостереження: періодично перевіряти, які домени AI-системи цитують за важливими тематичними питаннями. Це поки що значно менш стандартизована дисципліна, ніж rank tracking, тому робити з одиничної відповіді висновок про видимість домену не варто.
І точно не потрібно вигадувати окремий KPI на кшталт кількості згадок у ChatGPT без прив’язки до бізнес-результату. Видимість цікава лише тоді, коли вона допомагає бренду, лідам, продажам або хоча б створює вимірюваний попит.
SEO для двох читачів
Оптимізація під AI не вимагає переписувати інтернет мовою роботів. Швидше навпаки: сторінки мають стати менш двозначними й кориснішими.
Людині потрібні досвід автора, аргументи, приклади й нормальна мова. Машині — доступний HTML, зрозуміла структура, конкретні факти, зв’язки між сутностями та можливість визначити, хто і коли опублікував інформацію. У хорошого матеріалу ці вимоги майже не конфліктують.
Змінюється інше: між публікацією сторінки та її аудиторією більше немає гарантованого кліку. Частину інформації прочитає пошуковий робот, частину — AI-система, частину — агент, який виконує завдання від імені користувача. Іноді людина прийде на сайт, іноді отримає відповідь ще до переходу.
Тому наступний етап SEO, схоже, буде менше зводитися до боротьби за конкретну синю лінку. Завдання ширше: зробити ресурс технічно доступним, змістовно точним і достатньо авторитетним, щоб його використовували як джерело незалежно від того, хто першим відкрив сторінку — браузер людини чи програмний агент.